FREE OCR4PDF 7.0: Große PDFs schneller durchsuchbar machen
OCR4PDF 7.0: Neue Verarbeitung für große und gemischte PDF-Dokumente
Ein PDF mit wenigen gescannten Seiten lässt sich meist schnell in ein durchsuchbares Dokument verwandeln. Bei umfangreichen Dateien kommt es darauf an, wie die einzelnen Seiten verarbeitet werden. Genau hier setzt OCR4PDF 7.0 an: Die Verarbeitung wurde neu aufgebaut und läuft jetzt vom Eingabe-PDF bis zum fertigen OCR-PDF in einer Anwendung.
Große Dateien Seite für Seite verarbeiten
OCR4PDF rendert die Seiten nacheinander und übergibt ihre Bilddaten über eine begrenzte Warteschlange an die Texterkennung. Die gerenderten Seiten müssen dadurch nicht als vollständiger Bildstapel im Arbeitsspeicher liegen. Es gibt keine starre Dateigrößengrenze durch einen solchen Speicherstapel. Wie groß ein Dokument in der Praxis sein kann, hängt weiterhin vom verfügbaren Arbeitsspeicher und temporären Speicherplatz ab.
Mehrere OCR-Worker nutzen
Mehrere Worker können Seiten gleichzeitig erkennen. Die Anzahl ist einstellbar; die angebotene Obergrenze richtet sich nach der Hardware. Damit kann OCR4PDF die verfügbaren Prozessorkerne besser ausnutzen, besonders bei Dokumenten mit vielen gescannten Seiten.
Vorhandene Textseiten erhalten
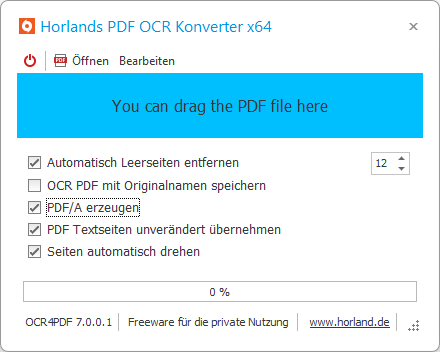
Viele PDFs enthalten sowohl gescannte Seiten als auch Seiten mit bereits vorhandenem Text. Ist die Option „Textseiten übernehmen“ aktiviert, prüft OCR4PDF jede Seite einzeln. Seiten mit ausreichend Text werden aus dem Original übernommen. Nur die übrigen Seiten gehen an die OCR-Worker. So bleiben vorhandene Textseiten erhalten und gemischte Dokumente können in einem Durchlauf verarbeitet werden.
OCR4PDF 7.0 macht damit vor allem die Arbeit mit großen Scan-PDFs und Dokumenten mit gemischtem Inhalt einfacher: PDF auswählen, Einstellungen festlegen und ein durchsuchbares PDF erhalten.
OCR4PDF 7.0: Durchsuchbare PDFs direkt aus der Kommandozeile
Viele PDF-Dateien entstehen als Scan und enthalten zunächst keinen durchsuchbaren Text. OCR4PDF 7.0 erkennt den Inhalt solcher Seiten und erstellt ein neues PDF mit Textsuche. Die neue CMD-Version macht diese Verarbeitung auch über die Windows-Eingabeaufforderung zugänglich.
OCR4PDF CMD speichert das Ergebnis als Scan_OCR.pdf neben der Eingabe. Die Originaldatei bleibt erhalten. Wer mehrere PDFs bearbeiten möchte, gibt stattdessen einen Ordner an. Mit -recursive werden auch Unterordner durchsucht; -destination legt ein separates Ziel fest:
OCR4PDF_CMD.exe -recursive -destination="D:\PDF-Ausgabe" "C:\PDF-Eingang"
Dabei bleibt die Struktur der Unterordner im Ziel erhalten. Die Originale werden nicht überschrieben. Bereits vorhandene Ausgabedateien und Dateien, deren Name auf _OCR.pdf oder _ORG.pdf endet, werden ausgelassen, damit ein erneuter Aufruf nicht denselben Bestand noch einmal verarbeitet.
Weiterführender Link: OCR4PDF-CMD-Hilfe mit allen Parametern, Standardwerten und Beispielen.